分布式面试
分布式理论
你知道分布式理论有哪些?
CAP 任何分布式系统无法同时满足Consistency(一致性)、Availability(可用性)、Participant tolerance(分区容错)这3个基本需求。最多只能满足其中两项,由于分区容错是必须的,因此一般是AP或者CP。
BASE BASE理论是对CAP的一种解决思路,包含三个思想:
Basically Available (基本可用):分布式系统在出现故障时,允许损失部分可用性,即保证核心可用。
Soft State(软状态):在一定时间内,允许出现中间状态,比如临时的不一致状态。
Eventually Consistent(最终一致性):虽然无法保证强一致性,但是在软状态结束后,最终达到数据一致。
1 说下你理解的CAP

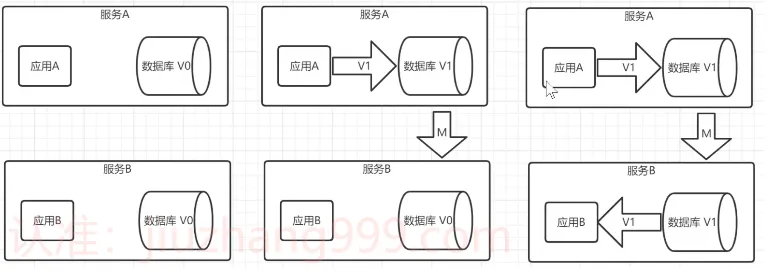
下图有两个节点服务A和服务B,服务A与服务B分别各有一个应用和数据库。
- 张三访问服务A,李四同时访问服务B
- 张三吧服务A数据从V0改为V1
- 服务A节点监测到数据变化执行M操作告诉了服务B
- 李四读取到的就是最新数据(正确数据)
一致性
一致性指所有节点同一时间数据完全一致
客户端
从客户端看,一致性注意指 高并发访问时更新过的数据如何获取的问题,
即张三李四同时访问如何获取最新正确的数据
服务端
从服务端看,是更新如何分布到整个系统,以保证数据最终一致,
即服务器A和服务器B如何通信保持数据一致
对于一致性,一致的程度不同可分为 强、弱、最终一致 三类
强一致性
对于关系型数据库,要求更新过的数据被后续访问都能看到,即强一致性。
张三更新数据后李四读取到的是最新数据。
弱一致性
容忍后续部分或者全部访问不到,则是弱一致
张三更新后李四-读取到的是老数据。
最终一致性
经过一段时间后要求访问到更新后的数据
张三更新后李四一段时间后读取到最新数据。
可用性
指服务一直可用,而且是正常响应时间。无论上面时间都可以正常获取数据值。
好的可用性指系统很好为用户服务,不出现用户操作失败或者超时等用户体验不好的情况。
分区容错性
遇到某节点或者网络分区故障时,仍然对外提供满足一致性或可用性的服务。
不满足分区容错性的服务就是一个服务出错,整个集群就无法提供服务。
如何取舍
- 牺牲分区容错性:这个不能牺牲,一旦出现网络问题整个服务集群不可用
- 牺牲数据一致性:张三看到库存100买了一件后,但是李四看到依然是100
- 牺牲可用性:张三看到库存100买了一件后,李四需要阻塞等待。
- 满足CA,满足一致性和可用性,舍弃分区容错性。意味着系统不是分布式的。
- 满足CP,满足一致性和容错性,舍弃可用性,系统允许有段时间的访问生效问题。
- 满足AP,满足可用性和容错性,舍弃一致性,系统在并发访问时出现数据不一致问题。
2 BASE理论
BASE理论是对CAP的一种解决思路,包含三个思想:
BASE全称:Basically Available(基本可用),Soft state(软状态),Eventually consistent(最终一致性)
CAP不可能同时满足,分区容错对于分布式是必须的。
Base理论是对CAP一致性和可用性权衡的结果,核心思想是: 即使无法做到 强一致性 ,每个系统根据业务特点采用适当的方式达到 最终一致性。
基本可用
假设系统出现不可预知的故障,相对正常系统而言:
- 响应时间上损失:正常情况0.5秒响应,基本可用的请求1秒左右回结果。
- 功能上的损失: 大促期间未来保护购物系统的稳定,可以关闭一些不重要的功能或者部分消费者引导到降级页面。
软状态
允许系统数据存在中间状态,并认为该状态不影响系统整体可用性,即系统多个不同节点的数据副本存在数据延迟。
最终一致性
在没用其他更新操作的情况下,数据最终一定达到一致的状态,因此所有客户端对系统的数据访问最终都能够获取最新的值。
上面说软状态,不可能一直是软状态,必须有时间限制。到了期限后,应当保证所有副本保持数据一致性。
3 Seata
Seata事务管理中有三个重要角色:
- TC 事务协调者: 维护全局和分支事务的状态, 协调全局事务提交或回滚
- TM事务管理器 : 定义全局事务的范围、开始全局事务、提交或回滚事务
- RM资源管理器 : 管理分支事务处理的资源,与TC交谈以注册分支事务和报告分支事务的状态

Seata基于上述架构提供四种不同的分布式事务解决方案:
- XA模式: 强一致性分阶段事务模式, 牺牲可用性, 无业务侵入
- TCC模式: 最终一致的分阶段事务模式, 有业务侵入
- AT模式: 最终一致的分阶段事务模式,无业务侵入, 也是默认模式
- SAGA模式: 长事务模式,有业务侵入
无论哪种模式都离不开TC事务协调者
3.1.引入依赖
首先,在order-service中引入依赖:
1 | <!--seata--> |
3.2.配置TC地址
在order-service中的application.yml中,配置TC服务信息,通过注册中心nacos,结合服务名称获取TC地址:
1 | seata: |
微服务如何根据这些配置寻找TC的地址呢?
我们知道注册到Nacos中的微服务,确定一个具体实例需要四个信息:
- namespace:命名空间
- group:分组
- application:服务名
- cluster:集群名
以上四个信息,在刚才的yaml文件中都能找到:

namespace为空,就是默认的public
结合起来,TC服务的信息就是:public@DEFAULT_GROUP@seata-tc-server@SH,这样就能确定TC服务集群了。然后就可以去Nacos拉取对应的实例信息了。
3.3XA模式
XA是一种规范,实现原理是基于两阶段提交
3.
分布式锁
分布式锁的实现方式有哪些?
对于单机系统,可用synchronizad或者ReentrantLock这些常规方式加锁,
但是对于集群系统本地锁无法解决问题,通常回引入第三方组件解决如
数据库、Redis、Zookeeper等。
数据库悲观锁(最少使用)
利用 select _ where _ for update 排他锁
1 | BEGIN; |
注意锁的级别,MySQL InnoDB默认行级锁,而行级锁基于 索引 ,
如果一条SQL走不到索引就不会使用行级锁,而是走表锁。
数据库乐观锁(较多使用)
乐观锁原理是CAS思想(交换并比较),是不具有互斥性
不会产生锁等待而消耗资源,操作过程中认为 不存在并发冲突
只有 update version 失败后才会察觉到。
1 | UPDATE |
如果不使用版本号的形式而是使用 标识符的形式如下:
1 | UPDATE |
标识符的形式会出现ABA问题
ABA问题:
在多个线程对同一变量进行多次修改的情况下,具体步骤如下:
- 线程1读取变量值为A。
- 线程2读取变量值为A,然后将其修改为B。
- 线程2再次将变量从B修改回A。
- 此时,线程1执行CAS操作,期望值为A,新值为C。由于当前值也是A,因此CAS操作成功。
虽然CAS操作成功了,但实际上变量已经被线程2修改过一次。
这就可能导致一些不希望发生的副作用,比如在某些情况下,这会导致某个状态被“隐藏”或者“丢失”。
同时也无法区分是第几次修改数据。
jdk支持AtomicStampedReference(原子有邮戳的参考)或者AtomicMarkableReference(原子有标记的参考) 来解决ABA问题,
当然也可用版本号的方式解决。
1 | UPDATE |
Redis分布式锁
Redis分布式锁 加锁就是在redis中,给key键设置一个值,为避免死锁,给定一个过期时间。
加锁
1 | SET lock_key random_value NX PX 5000 |
random_value是客户端生成唯一的字符串。PX 5000设置键的过期时间为5000毫秒.NX代表只有键不存在时,才对键进行设置操作。有值的话就添加失败。
命令通过检查键是否存在于数据库,
如果键不存在,Redis 会创建键并设置其值;如果键已存在,则不做任何操作。
由于 Redis 的单线程特性,所有的命令都是顺序执行的,这就保证了 SETNX 命令的原子性。
锁超时 问题
客户端A加锁同时设置超时时间是3秒,3秒后程序逻辑还没执行完毕,但是锁已经释放,
客户端B这时也来尝试加锁,那么客户端B也会加锁成功。
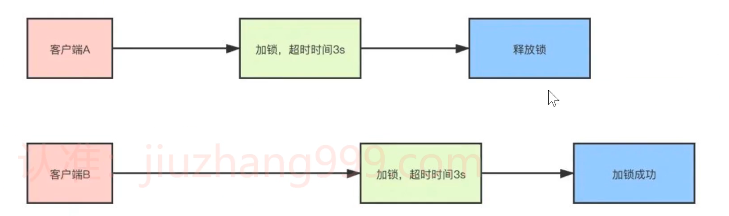
为了解决此问题,可在创建锁的同时创建守护线程,定义一个定时任务每隔一段时间为未释放的锁增加过期时间,当业务执行完释放锁后,再关闭守护线程。
这种锁续期的思想可以解决锁超时问题。
锁误删除
客户端A加锁同时设置超时时间3秒,结果3秒之后程序逻辑还没执行完成,锁已经释放。
客户端B此时来加锁,B加上锁后,客户端A代码执行完成开始执行释放锁,结果释放客户端B的锁。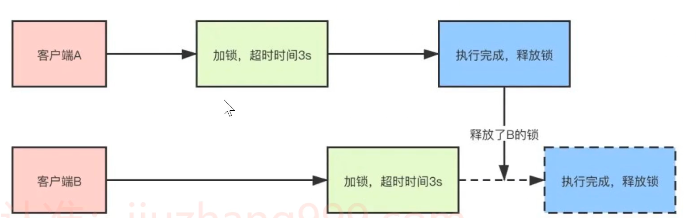
为了保证解锁的_原子性_,用LUA脚本完成,
先判断当前锁的字符串是否与传入的值相等,是的话才删除key。
删除key的时候通过random_value来判断是否为同一个客户端
1 | -- redis删除锁时判断锁的值是否和传入的值一致 |
RedLock
redlock是一种基于多节点redis实现分布式锁的算法,可以解决redis单点故障问题。
解决的问题:
在Redis主从架构下,主从同步 是异步的,
在Master节点加锁成功后指令没同步到Slave节点时,Master挂了,Slave提升新的Master,
新Master上没用锁的数据,
导致其他客户端仍然可以加锁成功的问题。
如何解决:
同时向一组节点发送加锁信息,半数响应成功则认为加锁成功,
每个锁都有生存时间(TTL),防止客户端崩溃导致锁不会释放。
客户端完成任务后向所有节点发送释放锁请求。
使用场景
- 必须保证分布式锁高可用
- 锁定时间长
zookeeper分布式锁
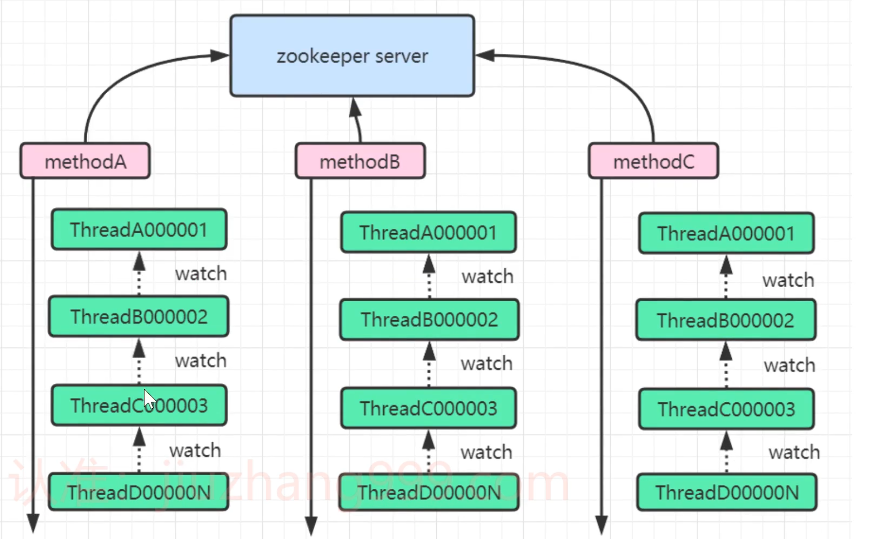
当某个线程要对方法加锁时,在Zookeeper创建一个与当前方法对应的夫节点,
每个要获取当前方法的锁的线程都会在夫节点下创建一个 临时有序节点 ,
因为临时有序节点序号是递增的,所以后续要获取锁的线程在zookeeper里的序号也是递增的。
根据这个特点,可以规定最小节点获取锁。
在并发下,每个线程都会在对应方法节点下创建属于自己的临时节点,且每个节点都是临时有序的。
临时节点避免 锁超时问题
有序节点,最小的节点自动获取执行权限,002的节点会自动监听001,当001执行结束后002会自动执行,003同理。
生成唯一主键
对数据和消息的唯一标识。
唯一主键的要求
全局唯一
不能出现重复的ID号,即唯一。
趋势递增
在MYSQL的InnoDB引擎中使用的是聚集索引,由于多数RDBMS使用BTree数据结构,
在主键上尽量有序保证写入性能。
单调递增
下一个ID一定大于上一个ID,例如事务版本号,增量消息等需求。
信息安全
如果ID是连续的,信息被泄露。(订单号)
含时间戳
开发中了解分布式ID的生成时间。
生成方案
数据库自增序列
实现简单,不适用于分库场景,不适用于特高并发场景。
UUID
生成简单,不连贯。
雪花算法
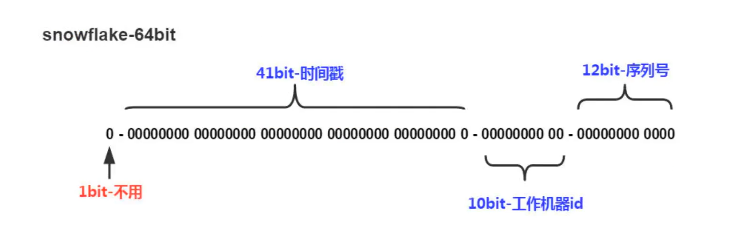
不依赖数据库等第三方系统,以服务的方式部署,稳定性高,生成ID的性能也非常高。
可自定义分配bit位,非常灵活。
雪花算法生成的ID可能产生的问题
依赖机器时钟,如果机器时钟回拨会导致重复ID的出现。
分布式事务
分布式事务指操作多个数据库的事务,为了保证分布式系统中数据一致性
分布式事务类型:
- 二阶段提交2PC
- 三阶段提交3PC
- TCC协议
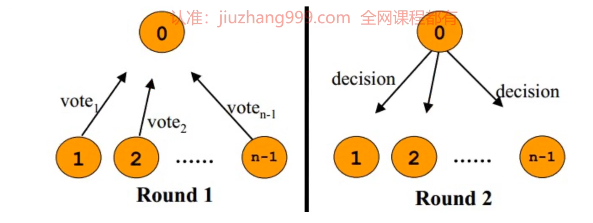
什么是2PC
参与者将操作成败通知协助者,再由协调者根据所有参与者的反馈情报决定 参与者是否提交或中止。
二阶段:
- 请求阶段(表决阶段)
- 提交/回滚阶段(执行阶段)
请求阶段
事务协调者通知每个参与者准备提交或取消事务,
进入请求阶段: 参与者写redo和undo日志,但是不提交事务,
同时告知协调者自己的状态 ,是本地事务执行成功或者是失败
提交阶段
基于请求阶段的投票决定 提交或取消
当且仅当所有参与者同意提交事务,协调者才通知所有的参与者提交事务,
否则协调者通知所有参与者取消事务
两阶段提交的缺点
同步阻塞问题
执行过程中,所有参与节点都是事务阻塞型的
单点故障
由于协调者的重要性,一旦协调者挂掉参与者就会一直阻塞。
数据不一致
在提交阶段(阶段二),协调者向参与者发送commit(提交)请求后,
发生了局部网络异常导致一部分参与者接收到了 提交请求,一部分没有提交,因而出现数据不一致问题。
3PC
三阶段提交协议在协调者和参与者中引入超时机制,
询问CanCommit,锁资源PreCommit,真正提交DoCommit
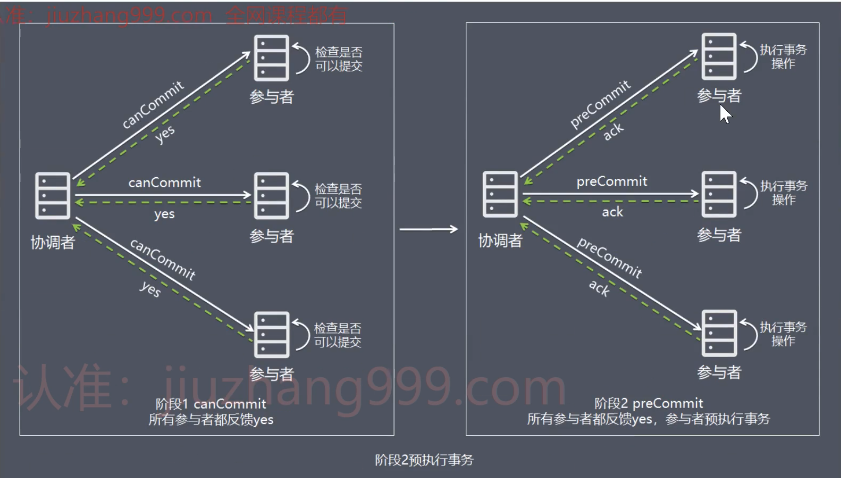
请求阶段 CanCommit
协调者向参与者发送canCommit请求,参与者可以提交响应yes,否则响应no,这一阶段叫SQL校验。
预提交阶段PreCommit
协调者根据参与者canCommit阶段的响应决定是否继续事务preCommit操作,根据响应有下面两种可能:
反馈成功
参与者都响应yes,执行事务预执行:
- 协调者向参与者发送
preCommit请求,进入prepared阶段。 - 参与者接收到
preCommit请求后将undo和redo信息记录到事务日志 - 每个参与者成功后响应
ACK并开始等待
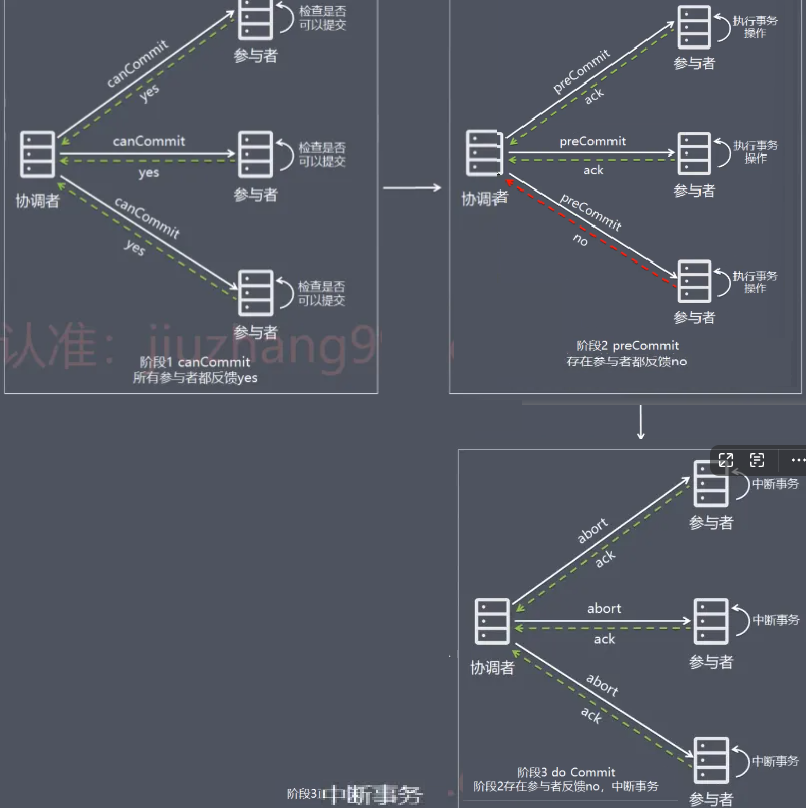
反馈失败
就要中断事务,协调者向参与者发送 `abort`请求,
参与者接收到或超时未接收到都会 执行事务中断。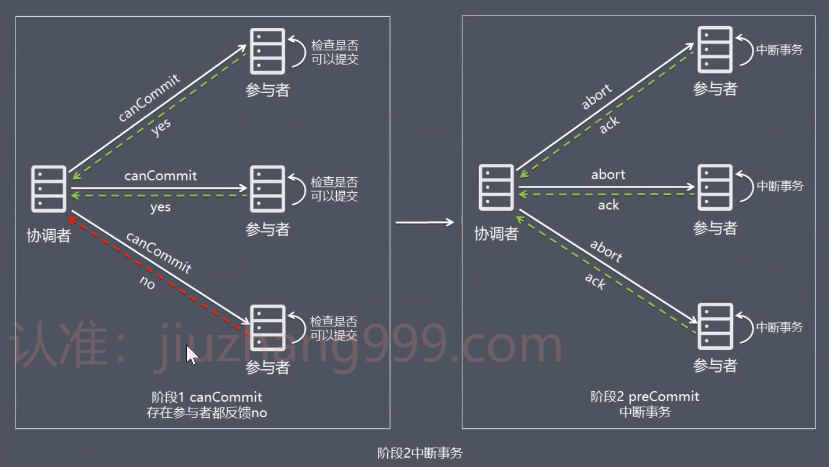
提交阶段DoCommit
协调者根据参与者preCommit阶段响应决定是否可以继续事务的doCommit 操作,
根据响应情况分为以下2种
反馈成功
所有的参数者都反映 ACK响应,执行事务提交
向所有参与者发送 doCommit请求,参与者提交成功后响应haveCommitted 的响应
协调者收到后完成任务。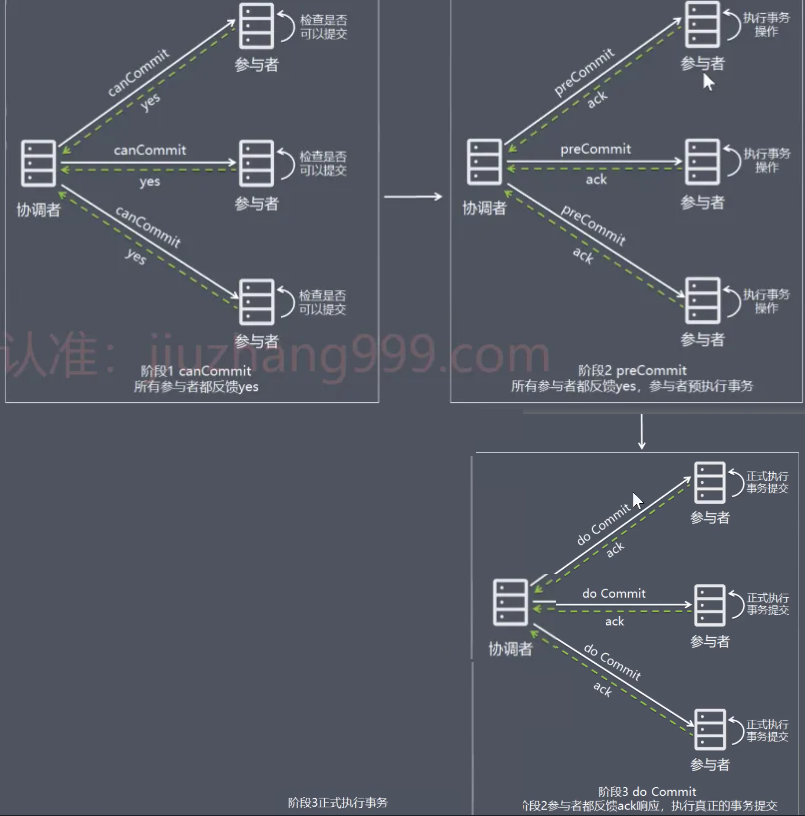
反馈失败
有参数者都反映 no响应,执行事务取消提交
向所有参与者发送 abort请求,参与者取消事务后响应ack 的响应
协调者收到后中断事务。
2PC和3PC的区别
3PC 的改进之处:
- 减少阻塞时间:在 CanCommit 阶段,参与者不需要锁定资源,只有在预提交阶段才会锁定资源。
- 解决单点故障问题:即使协调者在 PreCommit 阶段发生故障,参与者也可以根据预提交的结果决定是否提交事务。
Seata
Seata事务管理中有三个重要角色:
- TC 事务协调者: 维护全局和分支事务的状态, 协调全局事务提交或回滚
- TM事务管理器 : 定义全局事务的范围、开始全局事务、提交或回滚事务
- RM资源管理器 : 管理分支事务处理的资源,与TC交谈以注册分支事务和报告分支事务的状态
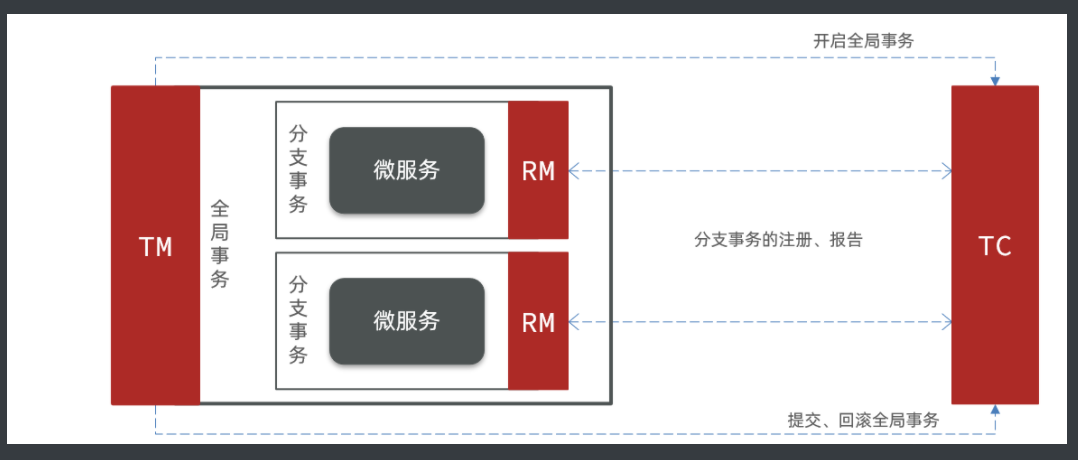
Seata基于上述架构提供四种不同的分布式事务解决方案:
- XA模式: 强一致性分阶段事务模式, 牺牲可用性, 无业务侵入
- TCC模式: 最终一致的分阶段事务模式, 有业务侵入
- AT模式: 最终一致的分阶段事务模式,无业务侵入, 也是默认模式
- SAGA模式: 长事务模式,有业务侵入
无论哪种模式都离不开TC事务协调者
实践
引入依赖
首先,在order-service中引入依赖:
1 | <!--seata--> |
配置TC地址
在order-service中的application.yml中,配置TC服务信息,通过注册中心nacos,结合服务名称获取TC地址:
1 | seata: |
微服务如何根据这些配置寻找TC的地址呢?
我们知道注册到Nacos中的微服务,确定一个具体实例需要四个信息:
- namespace:命名空间
- group:分组
- application:服务名
- cluster:集群名
以上四个信息,在刚才的yaml文件中都能找到:
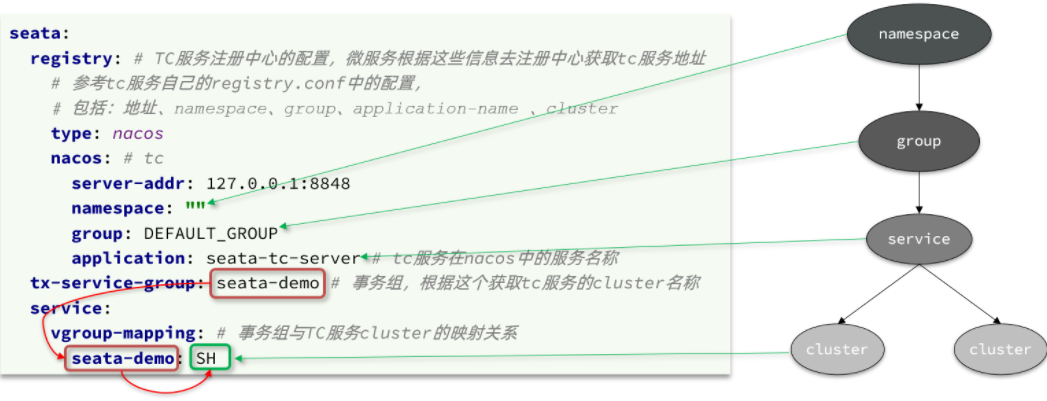
namespace为空,就是默认的public
结合起来,TC服务的信息就是:public@DEFAULT_GROUP@seata-tc-server@SH,这样就能确定TC服务集群了。然后就可以去Nacos拉取对应的实例信息了。
XA模式
XA是一种规范,实现原理是基于两阶段提交。
Seata 对原始的 XA 模式做了封装和改造:
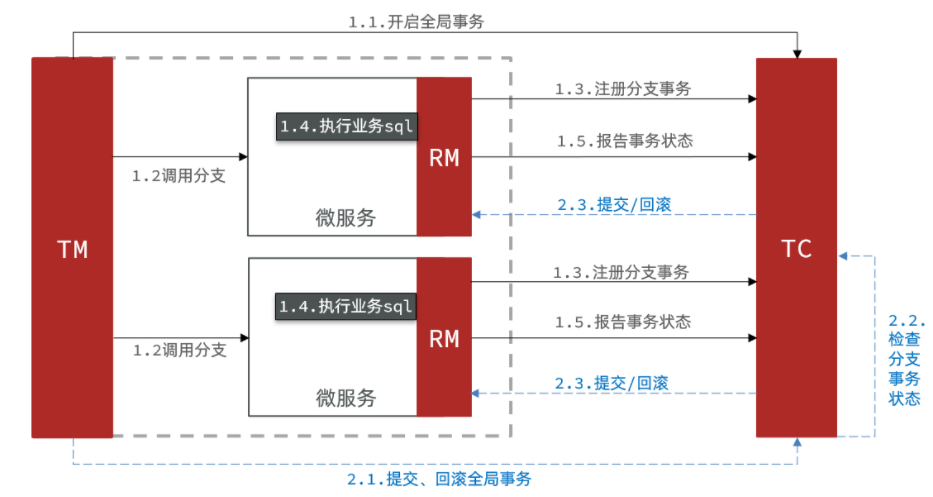
资源管理器 一阶段工作:
- 注册分支事务到 协调者
- 执行分支业务 sql 但不提交
- 报告状态到 协调者
协调者 二阶段工作:
- 如果 都成功, 通知所有提交
- 如果 有失败.通知所有回滚
资源管理器 二阶段:
接收 协调者指令, 提交或回滚事务
实现 XA 模式
修改 application.yml文件,开启 XA 模式:
1 | seata: |
给发起全局事务的入口方法添加 @GlobalTransactional 注解
当库存不足导致的事务回滚时:
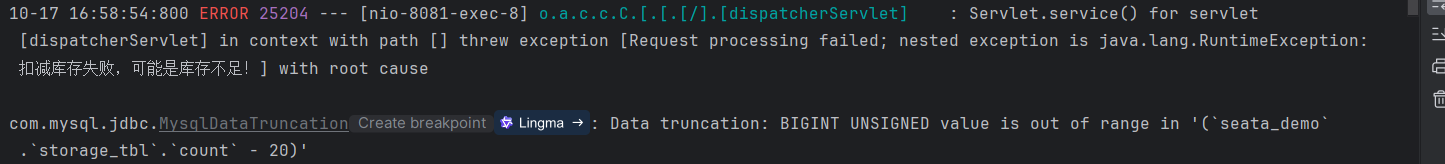
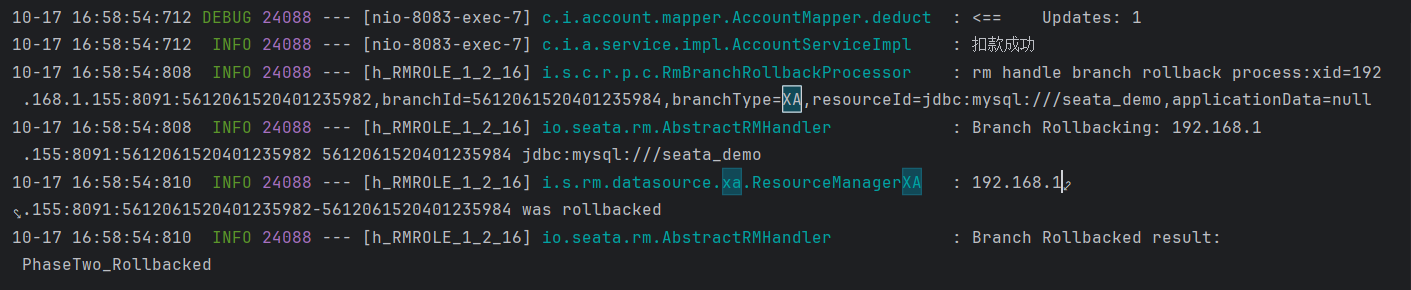
AT 模式
AT 同样是分阶段提交事务模型, 弥补了 XA 模式资源锁定周期过长的缺陷
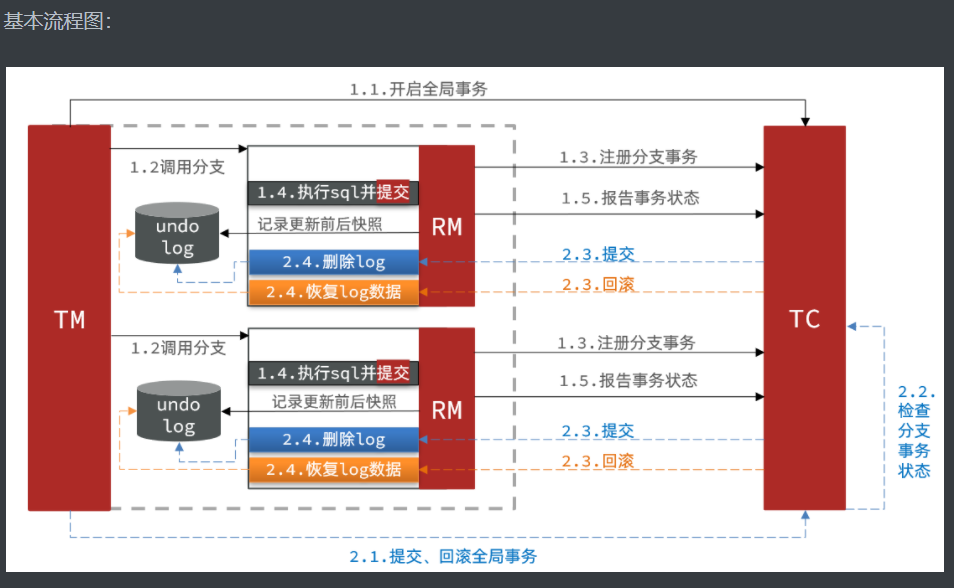 阶段一RM的工作:
- 注册分支事务
- 记录undo-log(数据快照)
- 执行业务sql并提交
- 报告事务状态
阶段二提交时RM的工作:
- 删除undo-log即可
阶段二回滚时RM的工作:
- 根据undo-log恢复数据到更新前
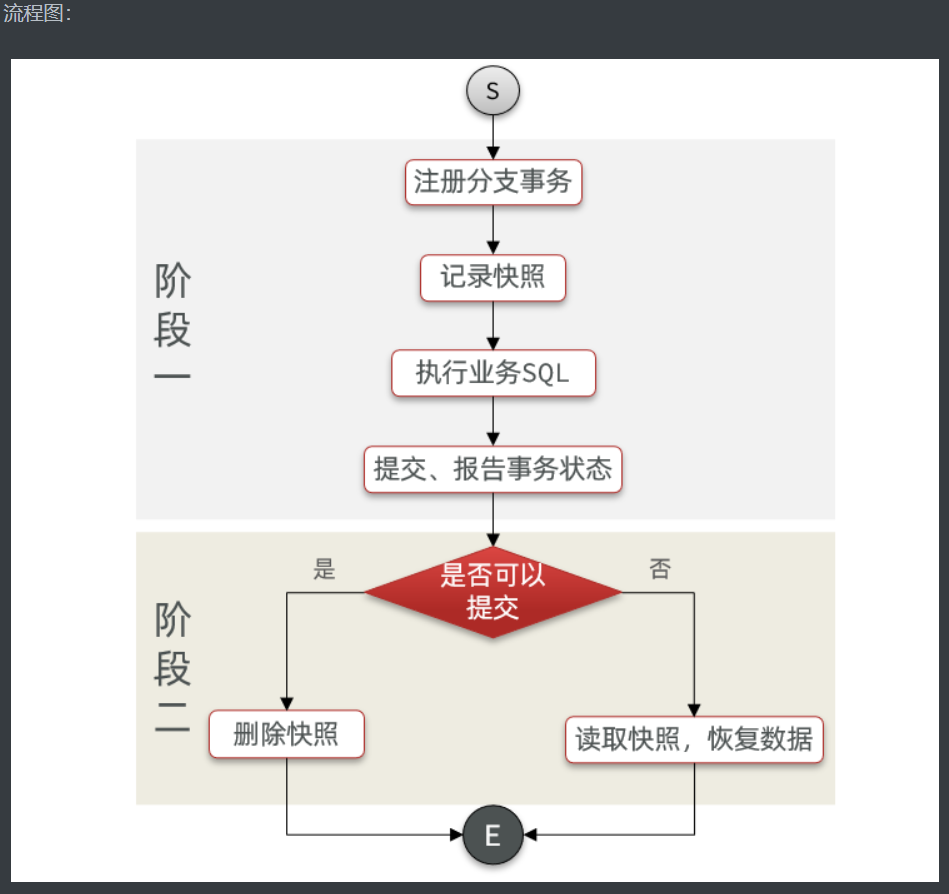
AT 与 XA 的区别
- XA 一阶段不提交事务, 锁定资源 ; AT 模式一阶段直接提交, 不锁定资源
- XA 依赖数据库机制实现回滚 ; AT 模式利用 快照 实现数据回滚
- XA 强一致性 ; AT 最终一致
AT 的多线程脏写问题(隔离性)
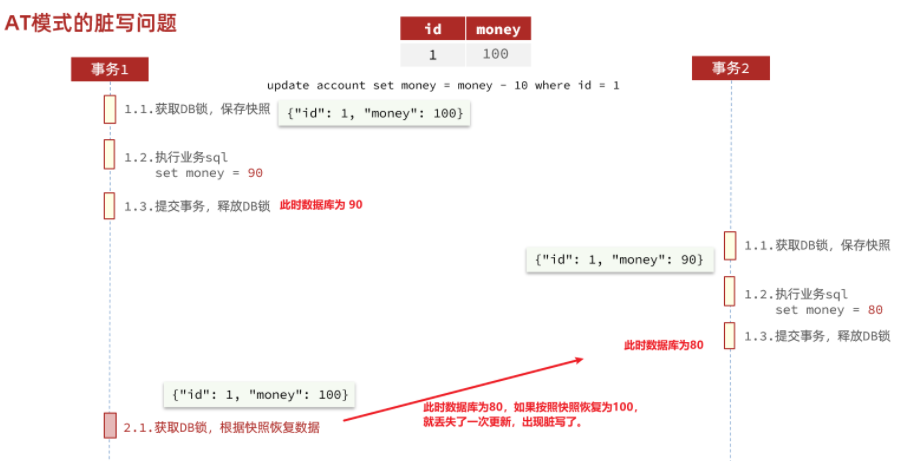
由于事务 1 在一阶段直接提交了事务, 在二阶段使用了快照回滚, 导致事务 2 一阶段的提交生效
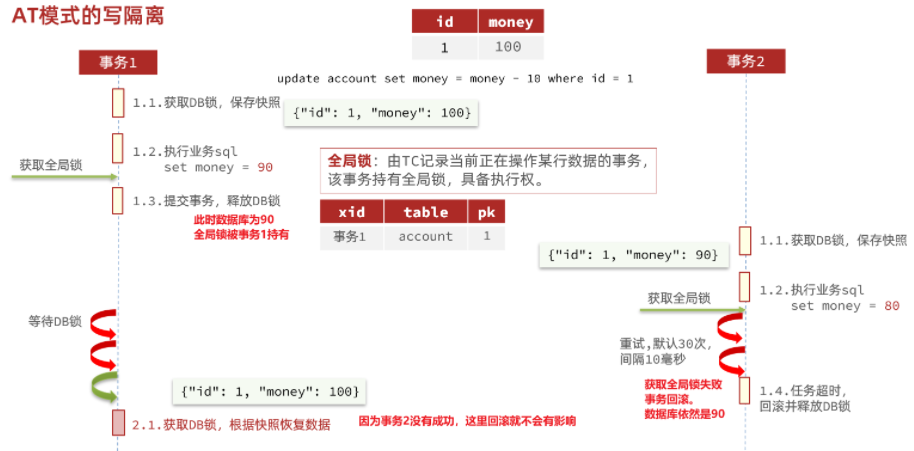
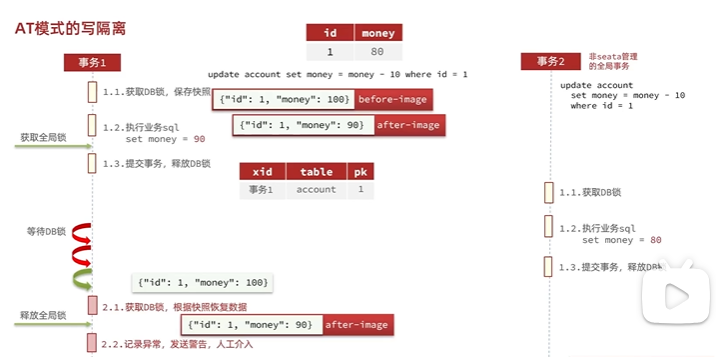
解决思路就是引入全局锁 .
假设有一个简单的银行转账场景,涉及两个账户 A 和 B:
事务 T1:
从账户 A 转账 100 元到账户 B。
获取全局锁,确保没有其他事务同时操作账户 A 和 B。
执行 SQL 语句,更新账户 A 和 B 的余额。
提交事务,释放全局锁。
事务 T2:
从账户 B 转账 50 元到账户 A。
尝试获取全局锁,但发现全局锁已被事务 T1 持有,因此等待。
事务 T1 提交后,事务 T2 获取全局锁,执行 SQL 语句,更新账户 A 和 B 的余额。
提交事务,释放全局锁。
通过全局锁机制,Seata 确保了在高并发环境下事务的正确性和一致性。
优缺点
优点
- 一阶段完成 提交事务, 释放数据库资源, 性能好
- 利用全局锁实现读写隔离
- 没有代码侵入, 框架完成回滚提交
缺点
- 两阶段是软状态, 最终一致
- 快照功能影响性能, 但被 XA 模式好
TCC 模式
- Try: 资源检测和预留
- Confirm: 业务, try 成功则 Confirm 一定成功
- Cancel: 释放预留资源
流程分析
假设 A 余额 100,需要扣除 30
- Try 阶段, 检测余额是否充足
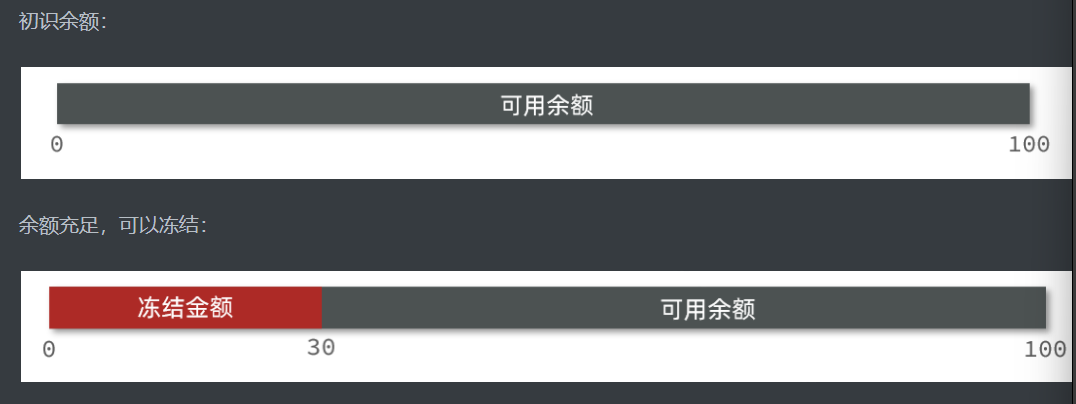
此时,总金额 = 冻结金额 + 可用金额,数量依然是100不变。事务直接提交无需等待其它事务。
- Confirm: 扣减冻结金额
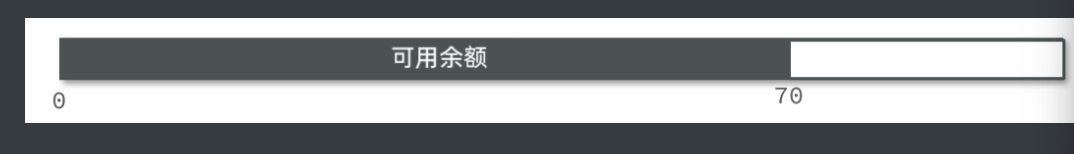
此时,总金额 = 冻结金额 + 可用金额 = 0 + 70 = 70元
- Canncel: 如果要回滚, 则释放冻结金额
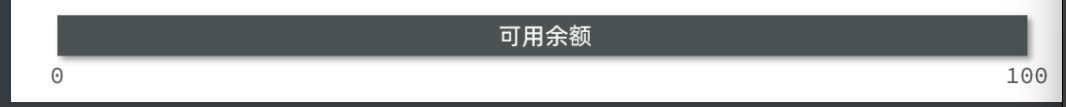
TCC 模型
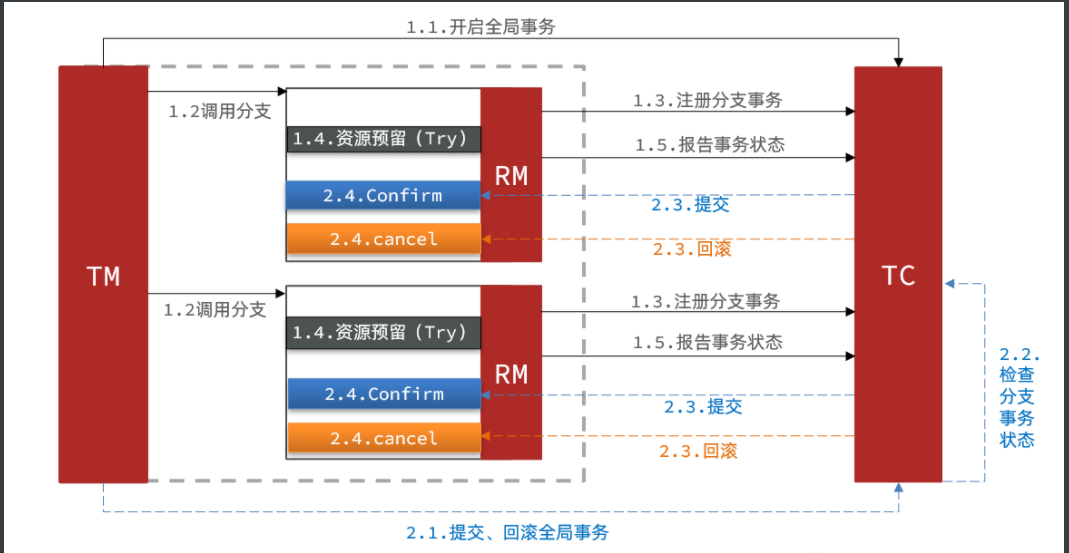
TCC 优缺点
- 一阶段直接提交事务, 释放资源
- 无需生成快照, 无需全局锁
- 不依赖数据库事务, 而是补偿操作, 可以用于非事务性数据库
缺点
- 有代码侵入
- 软状态, 事务是最终一致
- 做好幂等
TCC
TCC要求每个分支事务实现三个操作:预处理Try,确认Confirm,撤销Cancel
- Try操作业务检查及资源预留
- Confirm做业务确认操作
- Cancel实现于Try相反的操作(回滚操作)
- 发起所有分支事务的try操作
- 任何一个分支事务try执行失败,发起Cancel操作
- try操作全部成功,执行所有分支事务的Confirm做业务确认操作
预处理Try
此阶段完成:
- 完成所有业务检查(一致性)
- 预留必须业务资源(准隔离性)
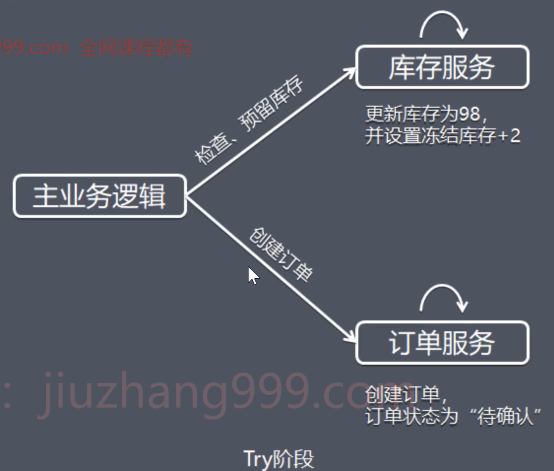 假设库存为100,购买数量为2,检查和更新库存的同时,冻结用户购买数量的库存,同时创建订单且订单状态为待确认。
确认阶段
根据try阶段是否正常执行,从而确认执行 确认操作Confirm 或者 取消操作CancelConfirm 和Cancel满足幂等性,如果执行失败会不断重试直到执行完成。
Confirm 确认
当try阶段全部正常执行,就执行确认操作 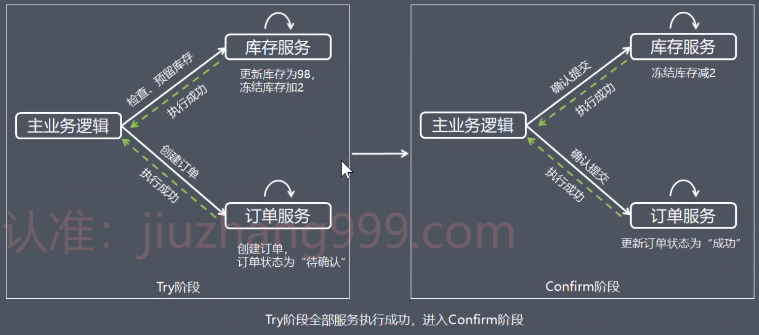 这里使用的资源是try阶段预留的业务资源,在TCC事务机制认为:try能正常预留资源则Confirm一定能正确提交。
Cancel撤销
当try阶段执行失败,就执行撤销操作 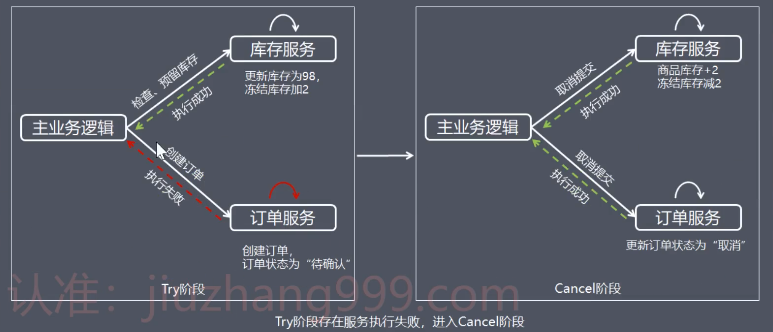 Cancel释放try阶段预留的业务资源,会把冻结的库存释放,并更新订单状态为取消。
优缺点
优点:
- 性能提升:具体业务实现控制资源锁的粒度变小,不会锁整个资源
- 数据最终一致性: 基于 Confirm 和Cancel的幂等性,保证事务最终完成或者取消,保证数据的最终一致性
- 可靠性: 解决了协调者单点故障问题,
引入 超时机制(try阶段完成后参与者设置超时时间,时间内没用收到 Confirm 和Cancel 也会自动执行。故障转移 当协调者故障可以有备用协调者管理事务。
假设协调者在发送 Confirm 请求后发生故障,参与者没有收到任何响应。在这种情况下,参与者将执行以下操作:
参与者检测到超时:参与者检查其内部状态,发现它处于 Try 状态。根据预先设定的策略,参与者自动执行本地 Commit。备用协调者接管:如果有备用协调者,它可以通过查询参与者的状态来确定事务的下一步动作。备用协调者可以发送 Confirm 或 Cancel 请求给参与者,以确保事务的一致性。
缺点:业务耦合,开发成本。
TCC常见异常
幂等处理
网络抖动可能会 重复调用同一个分布式事务种的一个分布式事务二阶段接口。导致资源重复使用或者释放。所以分支事务的二阶段接口 确认/回滚 需要保证幂等性。
应对策略引入幂等字段进行防重放攻击,新增一张事务状态控制表,表中有
- 主事务id
- 分支事务id
- 分支事务状态 (INIT初始化,CONFIRMED已提交,ROLLBACKED已回滚)
参与者的try方法,分支事务状态会写入INIT,二阶段的Confirm 和Cancel 将状态更新为CONFIRMED已提交,ROLLBACKED已回滚。
当重复调用二阶段接口,参与者会先获取事务状态控制表的对应记录,如果状态已经改为CONFIRMED已提交,ROLLBACKED已回滚 则无需再次执行,直接返回幂等成功。
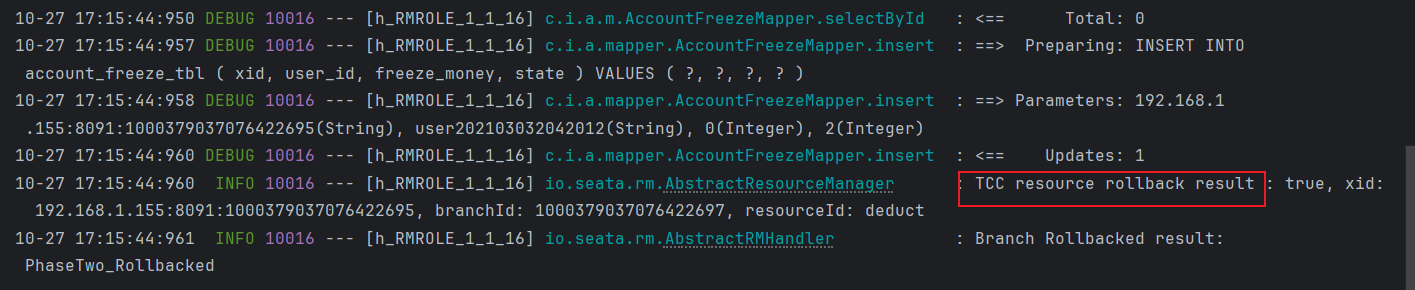
空回滚
某服务器没有调用try方法情况下,就调用了二阶段的Cancel方法。
当某分支事务的 try 阻塞时, 可以导致全局事务超时 而触发二阶段 cancel 操作
即 在未执行 try 操作时先执行了 cancel 操作, 就是空回滚
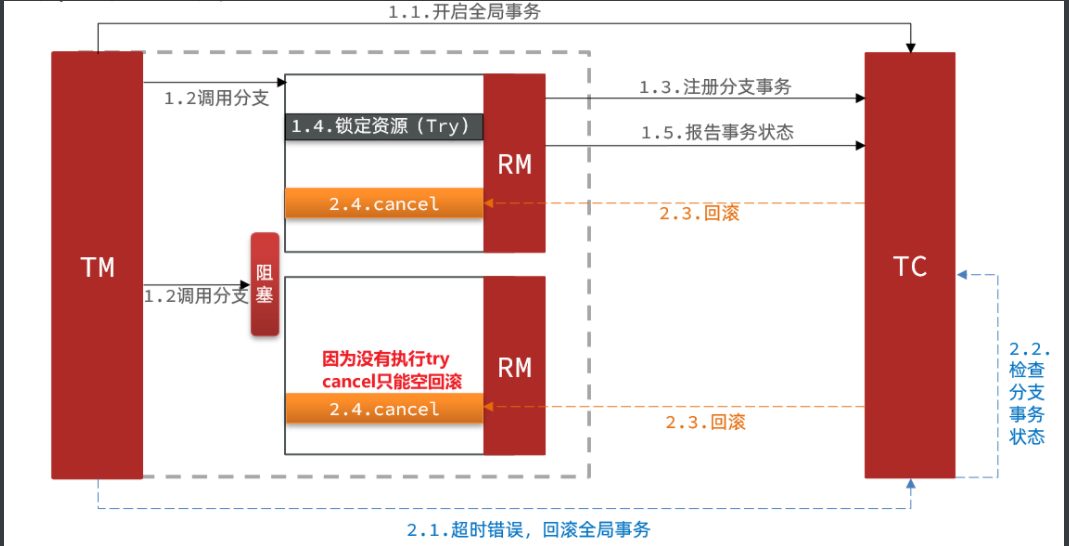
执行 cancel 操作时, 先判断 try 是否已经执行, 未执行则不执行 cancel
通过事务状态控制表来解决:
- 在 Try 操作成功执行后,参与者服务端记录一个事务状态。
- 在 Cancel 操作中,先检查是否存在 Try 操作的记录。
- 如果存在,则执行 Cancel 操作;如果不存在,则认为是空回滚,不做任何操作
资源悬挂
如果协调者在发送 Confirm 或 Cancel 请求后发生故障,参与者可能无法得知下一步的操作。参与者会处于悬挂状态,不知道应该执行 Confirm 还是 Cancel
解决:
- 实现超时机制来解决,参与者在 Try 阶段设置一个超时时间,如果在超时时间内没有收到 Confirm 或 Cancel 请求,则根据预设规则自动执行 Confirm 或 Cancel。
- 故障转移:使用备用协调者来接管事务管理。备用协调者可以通过查询参与者的状态来决定下一步的操作。
业务悬挂
对于已经空回滚的业务, 之前被阻塞的 try 操作恢复, 继续执行 try, 就不可能 Confirm 或 cancel,
事务一直处于中间状态, 这就是 业务悬挂
执行 try 时, 需要判断 cancel 是否已经执行了,如果已经执行, 应当阻止空回滚后的 try 操作, 避免悬挂
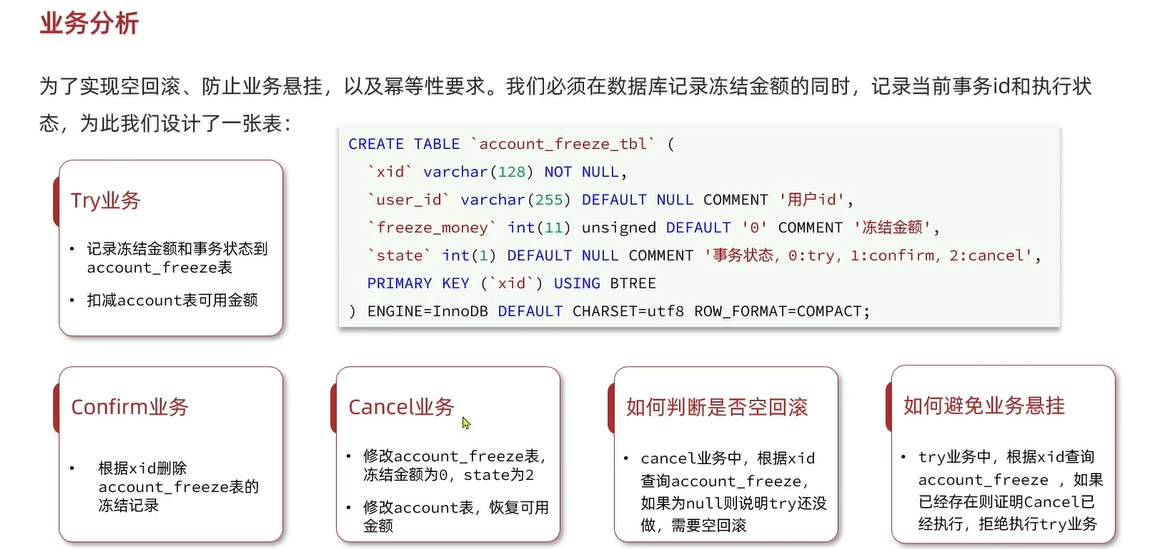
实现 TCC 模式
需求分析
创建表
unsigned 修饰的列只能存储非负数(即 0 和正数)。
1 | CREATE TABLE `account_tbl` ( |
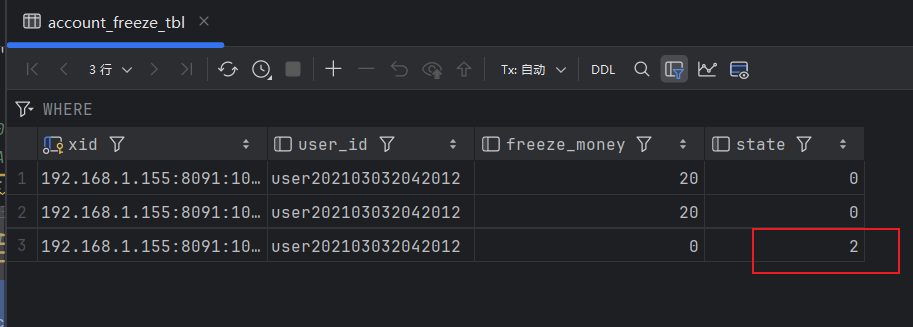
1 | CREATE TABLE `account_freeze_tbl` ( |
其中:
- xid:是全局事务id
- freeze_money:用来记录用户冻结金额
- state:用来记录事务状态
那此时,我们的业务开怎么做呢?
- Try业务:
- 记录冻结金额和事务状态到account_freeze表
- 扣减account表可用金额
- Confirm业务
- 根据xid删除account_freeze表的冻结记录
- Cancel业务
- 修改account_freeze表,冻结金额为0,state为2
- 修改account表,恢复可用金额
- 如何判断是否空回滚?
- cancel业务中,根据xid查询account_freeze,如果为null则说明try还没做,需要空回滚
- 如何避免业务悬挂?
- try业务中,根据xid查询account_freeze ,如果已经存在则证明Cancel已经执行,拒绝执行try业务
声明 TCC
@LocalTCC 写在类上, 表示 TCC
@TwoPhaseBusinessAction写在方法上, 表示该方法是 try 方法,
- 属性 name 值表示 try 阶段方法名称
- 属性 commitMethod 值表示 confirm 阶段方法名称
- 属性 rollbackMethod 值表示 cancel 阶段方法名称
@BusinessActionContextParameter写在方法参数前, 将该参数声明为三个阶段的公共参数
- 属性 paramName 值表示公共参数名称
TCC的Try、Confirm、Cancel方法都需要在接口中基于注解来声明,
我们在account-service项目中的<font style="background-color:rgba(255, 255, 255, 0);">cn.itcast.account.service</font>包中新建一个接口,声明TCC三个接口:
1 | /** |
1 |
|
SAGA 模式
是 seata 的长事务解决方案
- 一阶段: 直接提交本地事务
- 二阶段: 成功则什么都不做, 失败则通过编写补偿业务来回滚
优缺点
优点
- 事务参与者可以基于事件驱动实现异步调用, 吞吐高
- 一阶段直接提交事务, 无锁, 性能好
- 不用编写 TCC 的三个阶段, 实现简单
缺点
- 软状态持续时间不稳定, 时效性差
- 没有锁, 没有事务隔离, 会有脏写
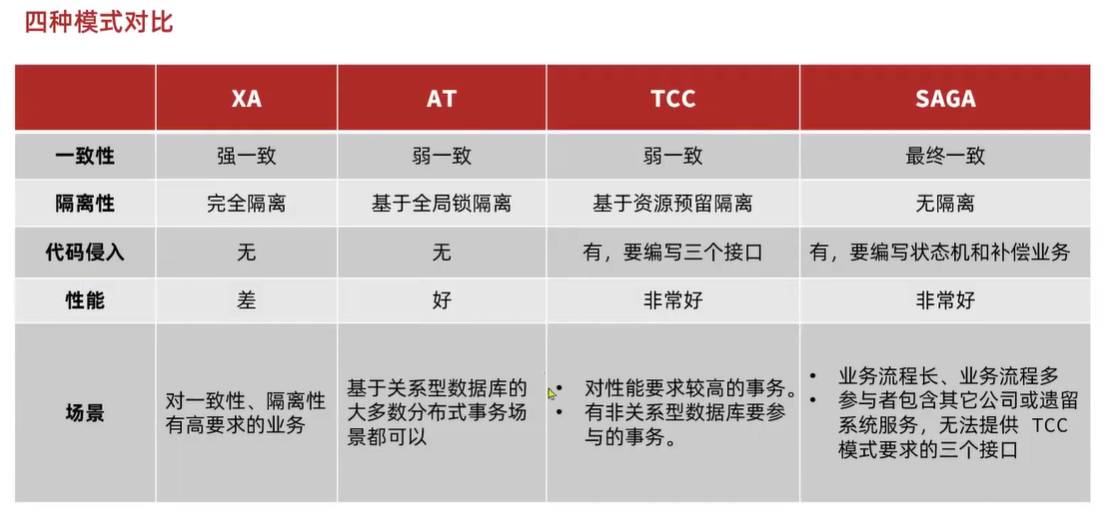
四种模式的对比
seata 的高可用
见仓库的根目录下
缓存一致性问题
先更新数据库,再删除缓存
a线程将数据库数据由5改为4, 再删除缓存前,b线程从缓存拿到数据5并执行。
优点:
如果缓存删除失败,数据库中的数据是最新的,可以保证数据的一致性。
缺点及问题:
- 如果在更新数据库之后、删除缓存之前,其他线程读取缓存中的旧数据,会导致缓存中的数据与数据库中的数据不一致。
- 如果删除缓存失败,旧的数据将保留在缓存中,直到缓存过期
解决方案:
- 延时双删:在更新数据库之后,先删除缓存,然后等待一段时间(例如几秒)后再删除一次缓存。这段时间内,如果有读取操作,缓存中找不到数据时会从数据库中读取最新的数据并重新加载到缓存中。
- 使用 CAS(Compare and Swap)操作:在缓存中使用 CAS 操作来保证缓存更新的原子性,确保缓存更新和删除操作要么全部成功要么全部失败。
- 使用发布/订阅机制:当数据更新时,发布一个事件,订阅者(缓存系统)接收到事件后删除对应的缓存条目
先删除缓存,再更新数据
a线程将缓存数据5删除, 再更新数据库前,
b线程从缓存拿不到数据 就 到数据库 读取数据5 并写入缓存
a线程然后修改数据库由5改4,
出现 数据库4 但是缓存是5的情况。
优点:
- 如果缓存删除成功,可以避免缓存和数据库之间的不一致性。
缺点及问题:
- 如果在删除缓存之后、更新数据库之前,其他线程尝试读取缓存中的数据,会因为缓存中没有数据而直接读取数据库中的旧数据,导致短暂的不一致性。
- 缓存已经被删除,可能会导致缓存穿透问题。
解决方案:
- 延时双删:与第一种方案类似,但在更新数据库之后再删除缓存,等待一段时间后再次删除缓存。
- 使用锁:在删除缓存前获取锁,确保在更新数据库期间缓存不会被其他线程访问。
- 使用消息队列:当数据更新时,将更新操作放入消息队列,由消费者异步处理更新数据库和删除缓存的操作,确保操作的顺序性和一致性。
